구글 Gemini Omni, 혼합 입력으로 일관된 영상 생성
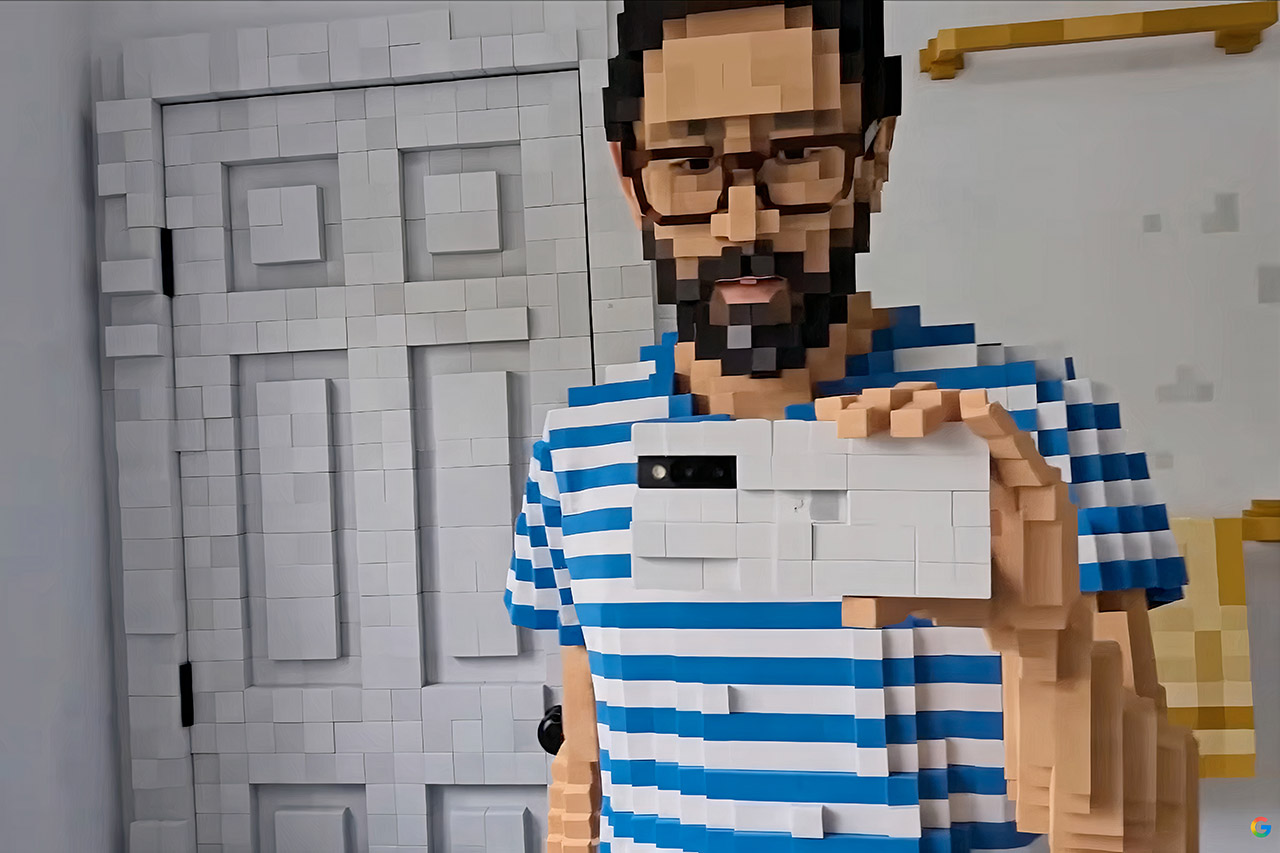
구글이 텍스트·이미지·오디오·영상을 통합 처리하는 Gemini Omni를 공개하며, 컨셉 이미지를 영상으로 변환하는 게임 파이프라인 활용이 기대돼요.
구글 딥마인드가 Google I/O 2026에서 텍스트·이미지·오디오·영상을 하나의 통합 시스템으로 처리하는 멀티모달 AI 모델 Gemini Omni를 공개했어요. 기존 AI 시스템들이 서로 다른 데이터 유형이 충돌할 때 혼란을 겪거나 각 입력을 별도 도구로 처리해야 했던 것과 달리, Gemini Omni는 네 가지 데이터 유형을 단일 네트워크에서 동시에 학습한 통합 모델이에요. 이 덕분에 중력이 구슬의 움직임에 영향을 주고 하프 줄을 튕기면 정확한 타이밍에 적절한 소리가 나는 것처럼 물리적 인과관계를 깊이 이해하며 자연스럽고 일관된 결과물을 만들어 낼 수 있어요.
초기 테스터들은 Gemini Omni를 활용해 스냅샷과 간단한 지시만으로 음성 해설이 포함된 스톱모션 시퀀스를 제작하고, 휴가 영상에서 불필요한 배경 요소를 제거하거나 전문 수준의 슬로건이 담긴 제품 사진을 생성하는 등 다양한 방식으로 활용했어요. 현재 Gemini Omni Flash 버전이 Gemini 앱, 크리에이티브 스튜디오 Flow, YouTube Shorts에서 사용 가능하며, 처음 생성되는 클립은 약 10초 분량으로 소셜 포스팅과 빠른 테스트에 적합해요. 구글은 품질 기준을 충족하면 더 강력한 Pro 모델을 출시할 예정이며, 몇 주 내에 개발자용 API도 제공할 계획이에요.
게임 제작 현장에서는 컨셉 이미지를 영상 클립으로 빠르게 변환하는 워크플로를 AI가 도와준다는 점이 가장 주목받고 있어요. 기존에는 컨셉 아트를 애니메이션으로 만들려면 여러 전문 소프트웨어와 방대한 편집 작업이 필요했지만, Gemini Omni는 이 과정을 대폭 단축해 줄 것으로 기대돼요. 향후 로드맵에는 오디오에서 이미지를 생성하거나 무음 영상에서 사운드트랙을 자동으로 만드는 기능도 포함돼 있어, 게임 트레일러와 시네마틱 제작 파이프라인에 미치는 영향이 점점 커질 것으로 보여요.
원문: TechEBlog